

Tóm tắt các điểm chính
- mHC (Manifold-Constrained Hyper-Connections) là kiến trúc mới của DeepSeek giải quyết vấn đề bất ổn khi mở rộng quy mô mô hình ngôn ngữ lớn (LLM)
- Hyper-Connections truyền thống tăng khả năng biểu diễn nhưng gây mất ổn định nghiêm trọng khi huấn luyện mô hình lớn – tín hiệu có thể phình lên hơn 3000 lần
- mHC khắc phục bằng cách ép buộc các luồng residual kết hợp theo quy tắc toán học nghiêm ngặt (ma trận doubly stochastic), giữ tín hiệu ổn định qua nhiều lớp
- Hiệu quả thực tế: Chỉ tăng 6.7% chi phí huấn luyện nhưng cải thiện 2.1% trên benchmark BIG-Bench Hard ở mô hình 27B tham số
- Ý nghĩa: Mở đường cho việc xây dựng mô hình AI quy mô nghìn tỷ tham số một cách ổn định và hiệu quả hơn
Khi nhắc đến việc mở rộng quy mô mô hình AI, phần lớn các nhóm nghiên cứu thường nghĩ đến việc “thêm GPU”. Nhưng thực tế không đơn giản như vậy. Tại một ngưỡng nhất định, việc huấn luyện trở nên bất ổn và hiệu suất không còn cải thiện dù bạn có đổ thêm bao nhiêu tài nguyên phần cứng đi chăng nữa.
DeepSeek vừa công bố một nghiên cứu vào ngày 31 tháng 12 năm 2025 với giải pháp mang tên mHC (Manifold-Constrained Hyper-Connections) – một kiến trúc mạng neural giải quyết chính xác vấn đề này. Đây không chỉ là một cải tiến về mặt lý thuyết, mà là một bước đột phá có thể định hình lại cách chúng ta xây dựng các mô hình AI quy mô lớn.
Tại sao Residual Connection truyền thống không còn đủ?
Để hiểu được giá trị của mHC, chúng ta cần quay lại với một khái niệm cơ bản: residual connection (kết nối residual).
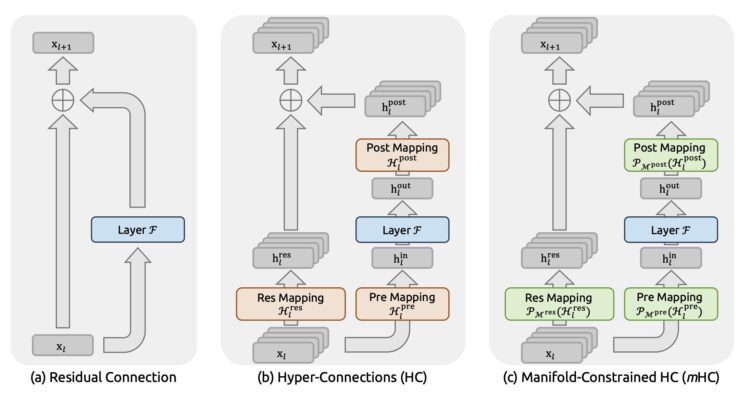
Từ năm 2016, khi ResNet ra đời, residual connection đã trở thành “xương sống” của hầu hết các mạng neural sâu. Ý tưởng cực kỳ đơn giản nhưng hiệu quả: thay vì ép mỗi lớp phải học một phép biến đổi hoàn toàn mới, ta cho phép nó học một “bản cập nhật nhỏ” và cộng thêm vào đầu vào ban đầu. Công thức cơ bản là:
output = layer(input) + input
Điều này giúp gradient lan truyền dễ dàng qua hàng trăm lớp mà không bị “tiêu tan” hay “bùng nổ” – hai vấn đề kinh điển của mạng neural sâu. Nhờ đó, việc huấn luyện mô hình sâu trở nên khả thi.
Tuy nhiên, residual connection truyền thống có một hạn chế lớn: nó chỉ duy trì một luồng thông tin duy nhất. Khi mô hình ngôn ngữ lớn ngày càng phức tạp với hàng chục tỷ tham số, một luồng duy nhất này trở thành “nút thắt cổ chai”. Nó buộc toàn bộ thông tin phải đi qua một con đường hẹp, ngay cả khi mô hình có đủ khả năng xử lý nhiều hơn thế.
Hyper-Connections: ý tưởng tốt nhưng chưa đủ ổn định
Để vượt qua giới hạn này, ByteDance đã đề xuất Hyper-Connections (HC) – một cải tiến mở rộng luồng residual từ một thành nhiều luồng song song. Thay vì một con đường duy nhất, mô hình giờ đây có thể duy trì nhiều luồng thông tin và cho phép chúng trao đổi với nhau thông qua các phép biến đổi có thể học được.
Về mặt lý thuyết, HC tăng khả năng biểu diễn của mô hình mà không làm tăng quá nhiều phép tính FLOPs cho mỗi lớp. Điều này nghe có vẻ hoàn hảo, nhưng khi mở rộng quy mô, HC gặp phải hai vấn đề nghiêm trọng:
Vấn đề 1: Bất ổn trong huấn luyện. Vì các luồng được phép trộn lẫn tự do ở mỗi lớp, những phép trộn nhỏ này tích lũy khi đi qua nhiều lớp. Kết quả là mạng không còn hoạt động như một “skip connection” sạch sẽ nữa – tín hiệu và gradient có thể bùng nổ hoặc biến mất. Trong thí nghiệm của DeepSeek trên mô hình 27B tham số, HC không ràng buộc gây ra hiện tượng tín hiệu tăng vọt hơn 3000 lần, dẫn đến sự sụp đổ hoàn toàn của quá trình huấn luyện.
Vấn đề 2: Chi phí phần cứng tăng cao. Ngay cả khi các phép tính bổ sung tương đối đơn giản, chi phí truy xuất bộ nhớ và truyền thông giữa các GPU tăng nhanh chóng. Ở quy mô lớn, những giới hạn thực sự thường không phải là số lượng phép tính (FLOPs), mà là băng thông bộ nhớ, truyền thông GPU-to-GPU và độ trễ.
Đây chính xác là những gì mHC được thiết kế để giải quyết.
mHC: đưa “lan can an toàn” vào Hyper-Connections
Manifold-Constrained Hyper-Connections (mHC) giữ lại ưu điểm của HC – nhiều luồng kết nối và khả năng trao đổi thông tin phong phú – nhưng bổ sung các ràng buộc toán học chặt chẽ để đảm bảo tính ổn định.
Ý tưởng cốt lõi: thay vì để các luồng residual trộn lẫn theo bất kỳ cách nào, mHC ép buộc việc trộn lẫn phải tuân theo quy tắc nghiêm ngặt. Cụ thể, mHC buộc ma trận trộn lẫn residual phải là một ma trận doubly stochastic – tức là:
- Tất cả các phần tử đều không âm
- Mỗi hàng và mỗi cột đều có tổng bằng 1
Điều này biến luồng residual thành một phép “trung bình có trọng số được kiểm soát”. Hãy tưởng tượng bạn có bốn ly nước (bốn luồng thông tin). Bạn có thể rót nước giữa các ly theo bất kỳ cách nào, miễn là tổng lượng nước không đổi và mỗi ly đều vừa cho vừa nhận. Không có ly nào được “thống trị” hay “bị bỏ rơi”.
Ràng buộc này mang lại nhiều tính chất toán học quan trọng:
Thuật toán Sinkhorn-Knopp: chìa khóa thực thi
Để biến một ma trận học được bất kỳ thành ma trận doubly stochastic, mHC sử dụng thuật toán Sinkhorn-Knopp – một phương pháp lặp được phát triển từ năm 1967. Thuật toán này hoạt động bằng cách:
- Lấy hàm mũ của ma trận để đảm bảo tất cả phần tử dương
- Chuẩn hóa các hàng để tổng bằng 1
- Chuẩn hóa các cột để tổng bằng 1
- Lặp lại bước 2-3 cho đến khi hội tụ
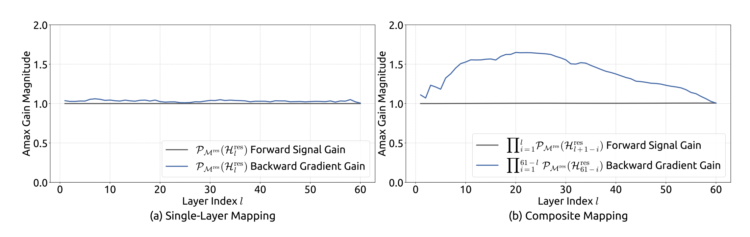
Điều thú vị là sự chuyển đổi từ bất ổn sang ổn định xảy ra gần như tức thì. Nghiên cứu của DeepSeek cho thấy chỉ sau một vài lần lặp Sinkhorn, tín hiệu composite gain ở độ sâu 64 lớp giảm từ mức 10^16 (bùng nổ hoàn toàn) xuống gần 1 (ổn định). Trong thực tế, 20 lần lặp là đủ để đảm bảo tính ổn định trong quá trình huấn luyện.
Tối ưu hóa hệ thống: không chỉ là lý thuyết
Tính ổn định thôi chưa đủ. Nếu mHC làm tăng quá nhiều lưu lượng truy cập bộ nhớ hoặc truyền thông GPU-to-GPU, chúng ta sẽ mất đi lợi thế về throughput. DeepSeek hiểu rõ điều này và đã kết hợp mHC với một loạt các tối ưu hóa hạ tầng được thiết kế để “thân thiện với bức tường bộ nhớ” (memory wall).
Kernel Fusion: giảm đọc/ghi bộ nhớ
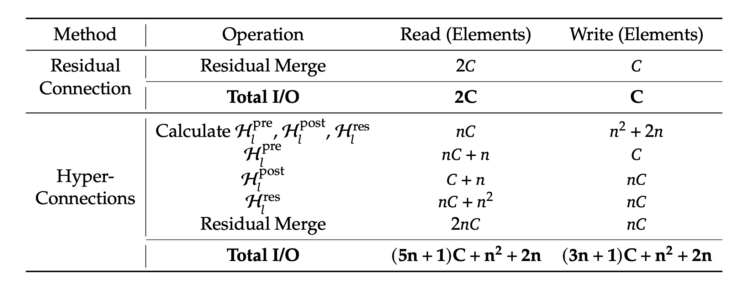
Thay vì áp dụng các phép biến đổi riêng lẻ (điều này buộc GPU phải ghi các tensor trung gian vào bộ nhớ rồi đọc lại), DeepSeek gộp nhiều bước vào một kernel GPU duy nhất. Việc này cắt giảm đáng kể lưu lượng bộ nhớ:
- Số lượng giá trị đọc giảm từ (3n+1)C xuống (n+1)C
- Số lượng giá trị ghi giảm từ 3nC xuống nC
Trong đó C là kích thước ẩn (số đặc trưng trên mỗi luồng) và n là số luồng residual. Ít đọc/ghi hơn nghĩa là ít dữ liệu di chuyển qua bộ nhớ hơn – đây là chìa khóa để tăng hiệu suất.
DeepSeek cũng triển khai hầu hết các kernel bằng TileLang để tận dụng băng thông bộ nhớ tốt hơn. Thậm chí cả việc thực thi thuật toán Sinkhorn cũng được đóng gói trong một kernel đơn với backward pass tùy chỉnh.
Recomputation: kiểm soát bộ nhớ Activation
Thiết kế multi-stream của mHC tăng số lượng activation trung gian cần lưu trữ cho backpropagation, điều này có thể làm “nổ tung” bộ nhớ GPU và buộc phải giảm batch size hoặc checkpoint tích cực hơn.
Để tránh điều này, DeepSeek sử dụng một thủ thuật đơn giản: không lưu trữ các activation trung gian của mHC sau forward pass. Thay vào đó, tính toán lại các kernel mHC nhẹ trong quá trình backward pass, trong khi bỏ qua việc tính toán lại lớp Transformer F đắt đỏ.
Chiến lược này giảm áp lực bộ nhớ và giúp duy trì throughput hiệu quả cao hơn.
Communication-Aware Scheduling với DualPipe
Ở quy mô lớn, pipeline parallelism rất phổ biến, nhưng thiết kế n-stream của mHC làm tăng lượng dữ liệu phải truyền qua các ranh giới pipeline stage, có thể tạo ra độ trễ truyền thông đáng kể.
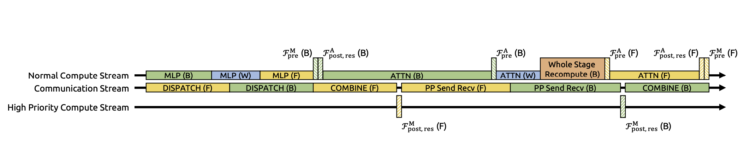
DeepSeek tối ưu hóa điều này bằng cách mở rộng DualPipe để chồng chéo truyền thông và tính toán tại các ranh giới pipeline. Điều này có nghĩa là GPU thực hiện công việc hữu ích trong khi các truyền tải diễn ra, thay vì ngồi chờ các lệnh send/receive hoàn thành. Họ cũng chạy một số kernel trên compute stream ưu tiên cao, để tính toán không chặn tiến trình truyền thông.
Kết quả là chi phí truyền thông bổ sung từ mHC được ẩn đi một phần, cải thiện hiệu quả huấn luyện end-to-end.
Bài học cho Inference: KV Cache và Memory Traffic
Mặc dù mHC chủ yếu là ý tưởng dành cho huấn luyện, bài học cốt lõi của nghiên cứu này áp dụng trực tiếp cho inference. Nghiên cứu nhấn mạnh rằng việc tối ưu hóa không chỉ cho FLOPs, mà còn cho lưu lượng bộ nhớ, truyền thông và độ trễ.
KV_bytes ≈ 2 × L × T × H × bytes_per_elem × batch
Với FP16/BF16, bytes_per_elem là 2. Ví dụ, với cấu hình điển hình (L=32 lớp, H=4096 đặc trưng ẩn, batch=1):
- 8K token → ~4 GB KV cache
- 128K token → ~64 GB KV cache
Ngay cả khi khối lượng tính toán vẫn hợp lý, bộ nhớ có thể “bùng nổ” và bạn trở nên bị giới hạn bởi băng thông. Đây là lý do tại sao các tối ưu hóa inference thực tế tập trung vào giảm thiểu di chuyển bộ nhớ thông qua:
- KV cache quantization (lượng tử hóa)
- Paged KV và eviction (phân trang và loại bỏ)
- Efficient attention kernels (FlashAttention-family)
- Continuous batching và shape bucketing
- Communication-aware parallelism
Mục tiêu là giữ lại lợi ích về hiệu suất mà không phải trả “thuế ẩn” trong việc đọc/ghi bộ nhớ và đồng bộ hóa.
Kết quả thực nghiệm: con số nói lên tất cả
DeepSeek đã thử nghiệm mHC trên các mô hình 3B, 9B và 27B tham số, với kết quả ấn tượng:
So với baseline tiêu chuẩn: mHC liên tục vượt trội trên hầu hết các benchmark So với HC không ràng buộc: mHC cải thiện +2.1% trên BIG-Bench Hard (BBH) và +2.3% trên DROP ở mô hình 27B Chi phí huấn luyện: Chỉ tăng khoảng 6.7% overhead – một mức tăng nhỏ đáng kinh ngạc so với lợi ích đạt được
Đặc biệt quan trọng, trong khi HC không ràng buộc thường gặp sự cố huấn luyện do gradient norm bất ổn (thường xảy ra quanh bước 12K), mHC huấn luyện trơn tru và đạt được loss thấp hơn với hiệu suất tốt hơn trên các benchmark về reasoning và ngôn ngữ.
Ý nghĩa rộng hơn: tương lai của kiến trúc ai
mHC không chỉ là một cải tiến kỹ thuật – nó đại diện cho một sự thay đổi tư duy trong cách chúng ta tiếp cận việc mở rộng quy mô mô hình AI.
Residual connections không thay đổi kể từ 2016. Cơ chế attention đã tiến hóa, kỹ thuật normalization đã nhân lên, kiến trúc FFN đã được thiết kế lại hàng chục lần. Nhưng skip connections? Hầu như không thay đổi. Không phải vì không ai thử – đã có công trình về dense connections, highway networks, các cơ chế gating khác nhau. Nhưng hầu hết đều thêm độ phức tạp mà không có lợi ích rõ ràng.
mHC cho thấy rằng cách các lớp kết nối với nhau có thể quan trọng không kém những gì xảy ra bên trong mỗi lớp. Bằng cách suy nghĩ lại về residual connections ở cấp độ cấu trúc, mHC mở ra cánh cửa cho các mạng neural an toàn hơn, phong phú hơn và có khả năng mở rộng quy mô tốt hơn.
Điểm nổi bật mà ngay cả khi không triển khai mHC, bạn cũng nên biết
Cách tiếp cận của DeepSeek cũng là một cách tốt để phát hiện nơi hệ thống thực sự đang mất thời gian:
Long-context workloads: Các prompt dài làm cho prefill trở nên đắt đỏ vì attention phải di chuyển nhiều dữ liệu qua bộ nhớ. Trong quá trình decode, KV cache tiếp tục tăng trưởng, làm tăng số lượng đọc bộ nhớ trên mỗi token. Cả hai đều đẩy băng thông bộ nhớ đến giới hạn và thường gây phân mảnh hoặc batching kém hiệu quả.
MoE routing và expert parallelism: Với Mixture of Experts (MoE), chi phí không chỉ là về tính toán. Đó là routing, token exchange và truyền thông cross-GPU cần thiết để gửi token đến các expert và thu thập outputs. DualPipe overlap của DeepSeek tập trung vào việc ẩn pipeline communication phía sau computation – điều mà MoE cần ở quy mô lớn.
Multi-tenant và small-batch traffic: Trong triển khai thực tế, các request không đến theo batch lớn gọn gàng. Chúng ta nhận được các batch nhỏ hơn, không đồng nhất, độ dài chuỗi khác nhau và cache reuse yếu hơn. Điều này làm tổn hại đến hiệu quả batching và làm tăng tail latency, khiến băng thông bộ nhớ và scheduling trở thành nút thắt cổ chai.
- Nova 2, Mistral 3 và các mô hình video SOTA mới nhất
- GPT-5.2: đánh giá, phân tích, hiệu suất thực tế, so sánh với đối thủ khác
- Cách dùng ChatGPT hiệu quả: Ví dụ Prompts thực tế cho mọi trường hợp sử dụng
- ChatGPT Health là gì? ChatGPT Health hoạt động như thế nào?
- Giải thích về LLM Agents: Kiến trúc & Các loại LLM Agents
- Claude Opus 4.6: Tính năng, benchmark và đánh giá chi tiết
- GPT-5.3 Codex: Từ trợ lý lập trình đến AI agent đa năng
- GPT-5.4: Tính Năng, Benchmark và Giá
- So sánh GLM-5 với GPT-5.3-Codex: Mô hình AI nào phù hợp với Agentic Workflow của bạn?
- Cursor Composer 2: rẻ hơn 86%, mạnh hơn Claude Opus 4.6, nhưng có giới hạn cứng cần biết
Kết luận
Điểm mấu chốt từ nghiên cứu này là việc mở rộng quy mô LLM không chỉ là vấn đề về FLOPs – nó cũng là vấn đề về tính ổn định và hệ thống. Hyper-Connections (HC) tăng cường khả năng của mô hình bằng cách mở rộng luồng residual và cho phép nhiều luồng trộn lẫn, nhưng ở độ sâu lớn, việc trộn lẫn này tích lũy thành một ánh xạ tổng hợp có thể lệch đáng kể khỏi con đường identity, dẫn đến bùng nổ/biến mất tín hiệu/gradient và sự sụp đổ của quá trình huấn luyện.
mHC khắc phục điều này bằng cách đặt lan can cho việc trộn lẫn đó – ràng buộc ma trận trộn lẫn residual phải là doubly stochastic (không âm, hàng/cột có tổng bằng 1), được thực thi thông qua Sinkhorn-Knopp, để con đường residual hoạt động như một phép trung bình có trọng số được kiểm soát và vẫn ổn định ngay cả khi bạn xếp chồng nhiều lớp.
DeepSeek cũng coi hiệu quả runtime là một phần của phương pháp. Họ sử dụng kernel fusion để giảm đọc/ghi bộ nhớ băng thông cao, và recomputation có chọn lọc để giảm thiểu bộ nhớ activation. Ngoài ra, họ mở rộng DualPipe để chồng chéo truyền thông với tính toán, đảm bảo rằng các điểm dừng pipeline không xóa bỏ lợi ích đạt được. Kết quả không chỉ là huấn luyện ổn định hơn, mà còn là hiệu suất downstream tốt hơn ở quy mô lớn.
Với việc CEO Liang Wenfeng đồng tác giả nghiên cứu này, rất có khả năng mHC sẽ xuất hiện trong mô hình flagship tiếp theo của DeepSeek. Điều này không chỉ mở ra khả năng xây dựng các mô hình AI với hàng nghìn tỷ tham số một cách ổn định, mà còn đánh dấu một bước ngoặt quan trọng trong cách chúng ta thiết kế kiến trúc cho thế hệ AI tiếp theo.
Câu hỏi thường gặp
mHC khác với Hyper-Connections (HC) tiêu chuẩn như thế nào?
Hyper-Connections tiêu chuẩn cho phép các luồng residual trộn lẫn tự do, điều này thường khiến tín hiệu bùng nổ hoặc biến mất khi đi qua nhiều lớp (bất ổn). mHC bổ sung một "lan can toán học" (sử dụng Sinkhorn-Knopp) buộc việc trộn lẫn này phải hoạt động như một phép trung bình có trọng số ổn định, khôi phục lại tính an toàn "identity shortcut" của ResNet tiêu chuẩn.
mHC có làm tăng độ trễ inference không?
Về mặt kỹ thuật, có, vì nó sử dụng nhiều luồng residual (n luồng) thay vì một, điều này tăng lưu lượng bộ nhớ. Tuy nhiên, DeepSeek giảm thiểu tác động này bằng cách sử dụng kernel fusion (kết hợp nhiều phép toán vào một lần chạy GPU duy nhất), nghĩa là penalty về độ trễ thực tế rất thấp so với lợi ích về hiệu suất.
Thuật toán Sinkhorn-Knopp làm gì trong ngữ cảnh này?
Đó là một phương pháp chuẩn hóa lặp. Trong mHC, nó lấy ma trận trộn lẫn đã học và liên tục chuẩn hóa các hàng và cột cho đến khi tất cả chúng đều có tổng bằng 1 (tạo ra ma trận "doubly stochastic"). Điều này đảm bảo tín hiệu không tăng trưởng không kiểm soát khi lan truyền qua mạng.
Tôi có thể áp dụng mHC cho các mô hình Transformer khác (như Llama hoặc GPT) không?
Có. mHC là một khối kiến trúc tổng quát, không phải một mô hình hoàn chỉnh. Bạn có thể thay thế các residual connection tiêu chuẩn trong hầu hết mọi kiến trúc dựa trên Transformer bằng các khối mHC để cải thiện tính ổn định huấn luyện và hội tụ, đặc biệt là cho các mô hình rất sâu.
Nguồn tham khảo
- https://arxiv.org/pdf/2512.24880