


Tóm tắt các điểm chính
- GPT-5.4 là mô hình đa năng thống nhất, thay thế GPT-5.2 Thinking trong ChatGPT và có sẵn qua API và Codex với context window thử nghiệm lên đến 1M token.
- Native computer use là tính năng đột phá nhất: GPT-5.4 điều khiển được desktop qua screenshot, chuột và bàn phím, thực hiện browser automation qua Playwright.
- Tool Search là cơ chế mới giúp giảm đáng kể token tiêu thụ khi làm việc với nhiều công cụ, thay vì nhúng toàn bộ định nghĩa công cụ vào prompt từ đầu.
- GPT-5.4 đạt 83% trên GDPval (44 ngành nghề), 52.1% trên Humanity’s Last Exam, và giảm 33% tỷ lệ lỗi thực tế so với GPT-5.2.
- Giá API tiêu chuẩn là 2.50 USD/1M input token và 15 USD/1M output token; phiên bản Pro là 30 USD/1M input và 180 USD/1M output.
GPT-5.4 là gì và khác gì các phiên bản trước?
GPT-5.4 là mô hình frontier thống nhất của OpenAI, kết hợp năng lực lập trình từ GPT-5.3-Codex với khả năng lý luận thành một mô hình duy nhất. Trước GPT-5.4, người dùng phải chuyển đổi giữa Codex để viết code và các mô hình khác cho tác vụ còn lại. GPT-5.4 xóa bỏ sự phân tách đó.
GPT-5.4 ra mắt chỉ hai ngày sau GPT-5.3 Instant, một bản cập nhật tập trung vào luồng hội thoại. Trong khi đó, GPT-5.4 hướng đến mục tiêu khác hẳn: tạo ra output có thể sử dụng trong công việc thực tế, từ bảng tính, bản trình bày, đến workflow tự động hóa.
GPT-5.4 có những tính năng mới nào quan trọng nhất?
Native computer use hoạt động như thế nào?
Native computer use là tính năng quan trọng nhất trong GPT-5.4 và là lần đầu tiên OpenAI tích hợp khả năng này vào mô hình đa năng. GPT-5.4 có thể đọc screenshot màn hình, điều khiển chuột và bàn phím, và viết code Playwright để tự động hóa browser. Điểm đáng chú ý là mô hình không chỉ đạt ngưỡng chấp nhận được mà còn vượt qua hiệu suất con người: 75% trên OSWorld-Verified so với 72.4% của người dùng thực.
Để so sánh mức độ tiến bộ: GPT-5.2 chỉ đạt 47.3% và GPT-5.3-Codex đạt 64.7% trên cùng benchmark. Bước nhảy từ 64.7% lên 75% trong một phiên bản là cải thiện đáng kể.
Tool Search giúp giảm chi phí như thế nào?
Tool Search là cơ chế API mới cho phép mô hình tải định nghĩa công cụ theo nhu cầu thay vì nhúng tất cả vào prompt từ đầu. Trong các hệ thống có nhiều công cụ, việc nhúng toàn bộ định nghĩa có thể thêm hàng chục nghìn token vào mỗi request. Tool Search loại bỏ overhead này bằng cách để mô hình tìm và gắn công cụ cần thiết vào đúng cuộc trò chuyện liên quan.
Kết quả là lượng token đầu vào giảm đáng kể trên nhiều loại tác vụ, góp phần vào con số 47% giảm token mà OpenAI báo cáo trên một số trường hợp cụ thể.
Context window 1M token và Steerability có ý nghĩa gì?
Context window 1M token hiện có trong Codex ở dạng thử nghiệm, đưa GPT-5.4 ngang hàng với Gemini 3 và Claude Sonnet 4.6 trong tác vụ cần duy trì lượng lớn thông tin. Ngưỡng tiêu chuẩn vẫn là 272K token, nhưng người dùng Codex có thể cấu hình mở rộng lên 1M.
Steerability là tính năng cho phép người dùng điều chỉnh hướng phản hồi ngay trong lúc mô hình đang xử lý. GPT-5.4 sẽ phác thảo kế hoạch trước khi tiếp tục, tương tự cơ chế của Codex, để người dùng có thể can thiệp nếu không đồng ý với hướng tiếp cận. Tính năng này đặc biệt hữu ích cho tác vụ lập trình phức tạp và nay được mở rộng sang các lĩnh vực công việc khác.
GPT-5.4 đạt kết quả ra sao trên các benchmark chính?
Benchmark công việc chuyên nghiệp: GDPval và Humanity’s Last Exam
GPT-5.4 đạt 83% trên GDPval, benchmark đánh giá AI trên 44 ngành nghề có giá trị kinh tế thực như quản lý dự án, phân tích tài chính và chăm sóc sức khỏe. Con số này so với 70.9% của GPT-5.2 và GPT-5.3-Codex. Riêng trong mô hình tài chính đầu tư (investment banking modeling), GPT-5.4 đạt 87.3% so với 79.3% của GPT-5.3-Codex.
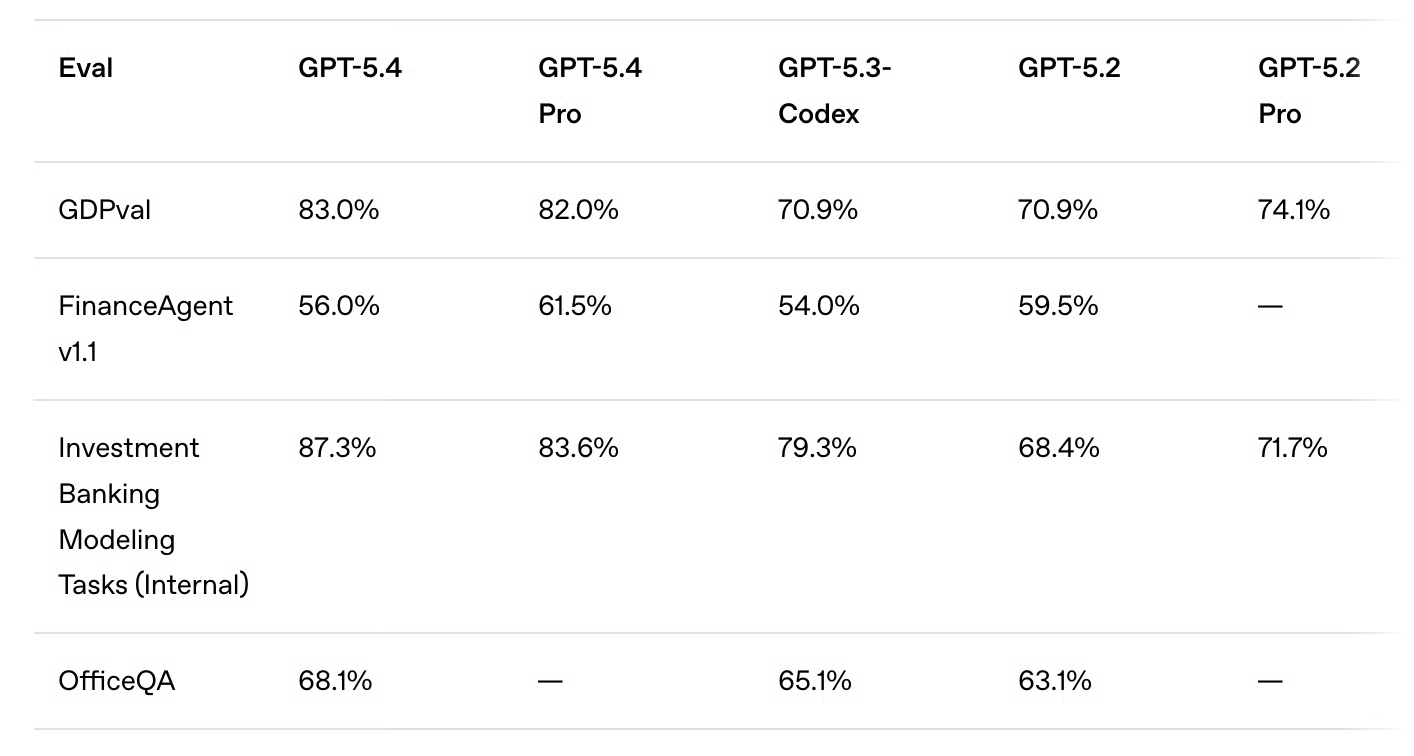
Trên GDPval-AA leaderboard, GPT-5.4 dẫn đầu với điểm 1667, xếp trên Claude Sonnet 4.6 (1633) và Claude Opus 4.6 (1606).
Trên Humanity’s Last Exam, GPT-5.4 vượt ngưỡng 50% với kết quả 52.1%, dù đánh giá độc lập từ Artificial Analysis cho điểm thấp hơn ở mức 41.6%, xếp sau Gemini 3.1 Pro (44.7%).
Benchmark lập trình và agentic tool calling
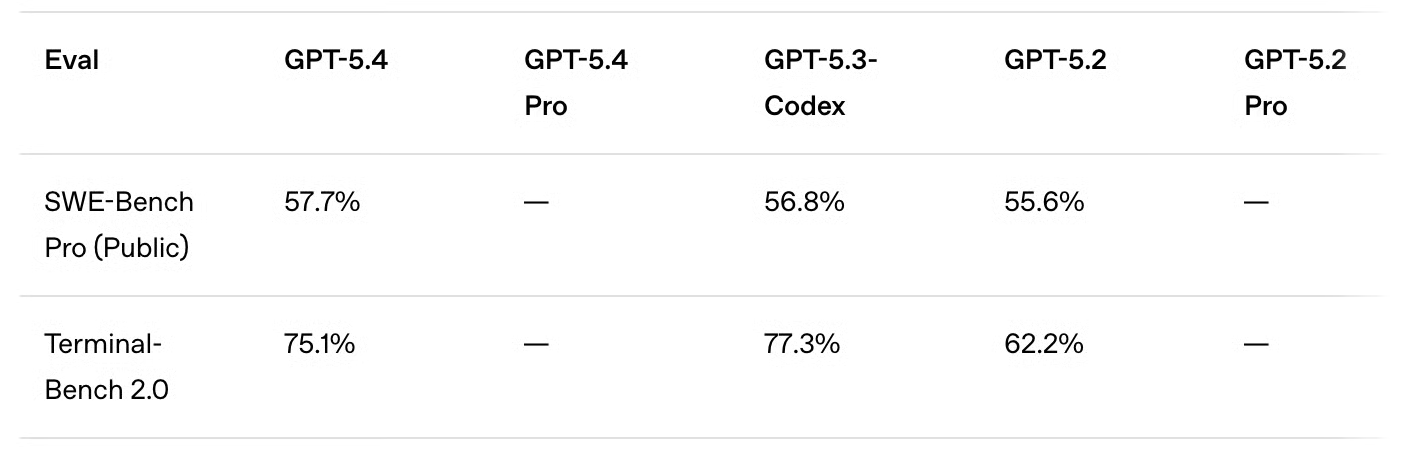
GPT-5.4 đạt 57.7% trên SWE-Bench Pro Public, cải thiện nhẹ so với GPT-5.3-Codex (56.8%) với latency thấp hơn. Trên Terminal-Bench 2.0 cho agentic task, GPT-5.4 đạt 75.0% so với 77.3% của GPT-5.3-Codex. Để so sánh: Gemini 3.1 Pro đạt 78.4% và Claude Opus 4.6 đạt 74.7% trên cùng benchmark này.
Về tool calling, GPT-5.4 đạt 54.6% trên Toolathlon và 82.7% trên BrowseComp (tìm kiếm web), trong khi phiên bản Pro đạt 89.3%.
Benchmark lý luận và toán học
GPT-5.4 đạt 93.7% trên ARC-AGI-1 và 73.3% trên ARC-AGI-2, tăng hơn 20 điểm phần trăm so với GPT-5.2 trên AGI-2. Phiên bản Pro đạt 83.3% trên ARC-AGI-2. Gemini 3 Deep Think hiện dẫn đầu cả hai với 96% và 84.6%.
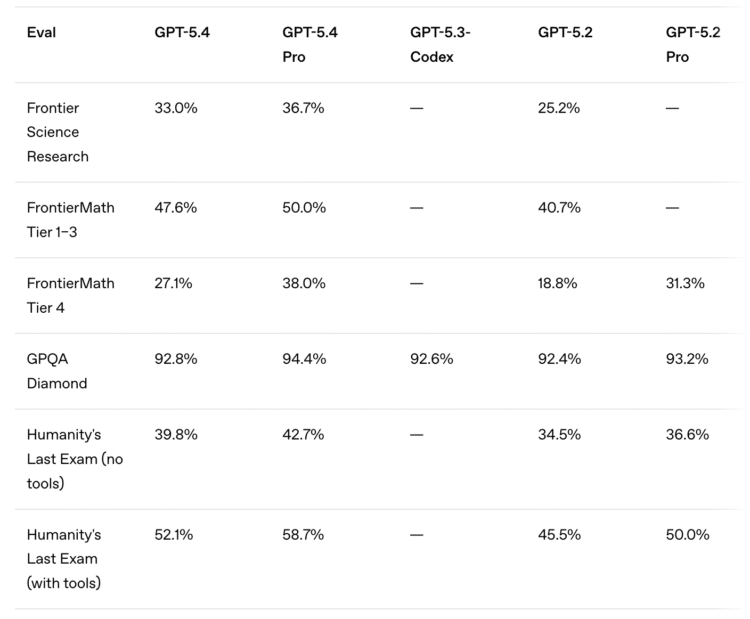
Về toán học, FrontierMath tăng từ 40.3% (GPT-5.2) lên 47.6% ở tầng trên và từ 18.8% lên 27.7% ở tầng dưới.
Bảng so sánh tính năng và benchmark
| Tiêu chí | GPT-5.4 | GPT-5.3-Codex | GPT-5.2 |
|---|---|---|---|
| Context window | 272K (chuẩn), 1M (Codex thử nghiệm) | Không có 1M | Nhỏ hơn |
| OSWorld-Verified | 75.0% (vượt con người) | 64.7% | 47.3% |
| GDPval | 83% | 70.9% | 70.9% |
| SWE-Bench Pro | 57.7% | 56.8% | Thấp hơn |
| Terminal-Bench 2.0 | 75.0% | 77.3% | 62.2% |
| ARC-AGI-2 | 73.3% | Không báo cáo | Thấp hơn |
| Humanity’s Last Exam | 52.1% | Không báo cáo | Thấp hơn |
| Tỷ lệ lỗi thực tế | Giảm 33% so với GPT-5.2 | Không báo cáo | Tham chiếu |
| Native computer use | Có | Không | Không |
| Tool Search | Có | Không | Không |
GPT-5.4 có giá bao nhiêu và có những gói nào?
GPT-5.4 được định giá cao hơn GPT-5.2 theo token, nhưng OpenAI lập luận rằng token efficiency từ Tool Search sẽ bù đắp phần lớn chi phí tăng thêm trong nhiều tác vụ.
| Gói | Giá input / 1M token | Giá output / 1M token |
|---|---|---|
| API tiêu chuẩn | 2.50 USD | 15 USD |
| Pro (hiệu suất tối đa) | 30 USD | 180 USD |
| Batch và Flex | Bằng một nửa giá tiêu chuẩn | Bằng một nửa giá tiêu chuẩn |
| Priority processing | Gấp đôi giá tiêu chuẩn | Gấp đôi giá tiêu chuẩn |
GPT-5.4 có những cập nhật an toàn nào đáng chú ý?
Chain-of-Thought controllability và mức độ rủi ro thực tế
OpenAI công bố nghiên cứu đồng hành về Chain-of-Thought (CoT) controllability, kiểm tra liệu mô hình lý luận có thể che giấu quá trình suy nghĩ để vượt qua bộ lọc an toàn không. Kết quả trên 13 mô hình frontier cho thấy tỷ lệ controllability dao động từ 0.1% đến tối đa 15.4%, nghĩa là các mô hình hầu như không thể che giấu hay định hình lại quá trình lý luận ngay cả khi được yêu cầu làm vậy.
Giảm từ chối không cần thiết
GPT-5.4 được thiết kế giảm bớt các từ chối thái quá so với GPT-5.2, vốn bị đánh giá là quá thận trọng trong nhiều tình huống công việc bình thường. Mục tiêu là để mô hình có thể thực hiện đầy đủ công việc chuyên nghiệp hợp lệ mà không bị chặn không cần thiết, đặc biệt quan trọng khi GPT-5.4 được định vị cho GDPval-level professional work.
- ChatGPT Health là gì? ChatGPT Health hoạt động như thế nào?
- Giải thích về LLM Agents: Kiến trúc & Các loại LLM Agents
- DeepSeek mHC: giải pháp đột phá giúp huấn luyện mô hình AI quy mô lớn ổn định hơn
- Claude Opus 4.6: Tính năng, benchmark và đánh giá chi tiết
- GPT-5.3 Codex: Từ trợ lý lập trình đến AI agent đa năng
- So sánh GLM-5 với GPT-5.3-Codex: Mô hình AI nào phù hợp với Agentic Workflow của bạn?
- Cursor Composer 2: rẻ hơn 86%, mạnh hơn Claude Opus 4.6, nhưng có giới hạn cứng cần biết
- Cursor 3 là gì và nó thay đổi cách lập trình như thế nào?
- Muse Spark là gì? Meta trở lại cuộc đua AI frontier với model mạnh nhất từ trước đến nay
- Claude Opus 4.7 là gì và có gì mới?
Kết luận
GPT-5.4 đánh dấu một bước chuyển thực chất từ AI hội thoại sang AI thực thi công việc. Ba điểm mạnh cốt lõi là: native computer use đạt 75% trên OSWorld-Verified vượt qua con người, Tool Search giảm đáng kể token overhead trong workflow nhiều công cụ, và hiệu suất chuyên nghiệp 83% trên GDPval qua 44 ngành nghề. Các bài kiểm tra thực tế xác nhận mô hình thực sự tốt trong code refactoring, lý luận có cấu trúc và từ chối yêu cầu phi đạo đức, nhưng vẫn cần sự kiểm tra của chuyên gia trong tác vụ ngành đặc thù như y tế.
Định số đáng nhớ nhất: GPT-5.4 là mô hình đầu tiên vượt qua con người trong autonomous computer use. Đây không phải thông báo marketing mà là kết quả trên benchmark chuẩn, và nó thay đổi cách nghĩ về vai trò của AI trong môi trường làm việc chuyên nghiệp.
Câu hỏi thường gặp
GPT-5.4 là gì?
GPT-5.4 là mô hình frontier mới nhất của OpenAI, kết hợp năng lực lập trình của GPT-5.3-Codex với khả năng lý luận vào một mô hình thống nhất, tập trung vào công việc chuyên nghiệp thực tế và là mô hình đầu tiên có native computer use.
GPT-5.4 có thể truy cập qua đâu?
GPT-5.4 thay thế GPT-5.2 Thinking trong ChatGPT và có sẵn qua OpenAI API và Codex. Context window 1M token hiện chỉ ở dạng thử nghiệm trong Codex; ngưỡng tiêu chuẩn là 272K token.
Native computer use của GPT-5.4 là gì?
Native computer use là khả năng GPT-5.4 tương tác trực tiếp với desktop thông qua screenshot, điều khiển chuột và bàn phím, và viết code Playwright để tự động hóa trình duyệt. Đây là lần đầu tiên OpenAI tích hợp tính năng này vào mô hình đa năng, đạt 75% trên OSWorld-Verified.
GPT-5.4 có giá bao nhiêu?
API tiêu chuẩn: 2.50 USD/1M input token và 15 USD/1M output token. Phiên bản Pro: 30 USD/1M input và 180 USD/1M output. Batch và Flex processing có giá bằng một nửa.
GPT-5.4 có chính xác hơn các phiên bản trước không?
Có. GPT-5.4 giảm 33% tỷ lệ sai trong từng câu và giảm 18% tỷ lệ phản hồi chứa bất kỳ lỗi nào so với GPT-5.2, dựa trên dữ liệu từ người dùng gắn cờ lỗi thực tế. Tuy nhiên, với tác vụ chuyên ngành đặc thù, sự kiểm tra của chuyên gia vẫn là bắt buộc.