

Nghịch lý Simpson, được đặt theo tên nhà thống kê Edward H. Simpson (1951), là một hiện tượng thống kê trong đó kết luận tổng thể về một tập hợp dữ liệu có thể mâu thuẫn với kết luận khi dữ liệu được chia thành các nhóm nhỏ hơn. Hiện tượng này không chỉ là một câu đố toán học mà còn có ý nghĩa sâu rộng trong y học, kinh tế học, và phân tích dữ liệu, nơi các quyết định dựa trên số liệu tổng thể có thể dẫn đến sai lầm nếu không xem xét các yếu tố ẩn. Nghịch lý Simpson mời gọi chúng ta suy nghĩ cẩn trọng về cách diễn giải dữ liệu trong cuộc sống. Cá nhân tôi thấy bài toán này hấp dẫn vì nó phơi bày cách trực giác có thể bị đánh lừa bởi các con số, đồng thời nhắc nhở rằng sự thật đôi khi ẩn sau những tầng dữ liệu phức tạp.
Định nghĩa và cơ chế của nghịch lý Simpson
Nghịch lý Simpson xảy ra khi mối quan hệ giữa hai biến (như hiệu quả điều trị và bác sĩ) đảo ngược khi dữ liệu được phân chia theo một biến thứ ba (như mức độ nghiêm trọng của bệnh). Cụ thể, một xu hướng quan sát được trong các nhóm nhỏ có thể bị đảo ngược hoặc biến mất khi dữ liệu được tổng hợp, do sự khác biệt trong tỷ trọng của các nhóm.
Công thức cơ bản của nghịch lý có thể được minh họa qua tỷ lệ xác suất có điều kiện. Cho hai biến XX (ví dụ: bác sĩ) và YY (kết quả điều trị), với biến điều chỉnh ZZ (mức độ bệnh), xác suất tổng thể P(Y∣X)P(Y|X) có thể mâu thuẫn với P(Y∣X,Z)P(Y|X, Z) do sự khác biệt trong phân bố của ZZ giữa các giá trị của XX.
Ví dụ minh họa nghịch lý Simpson
Ví dụ minh họa: Bác sĩ An và Bình
Hãy xem xét một tình huống giả định: Bạn cần chọn bác sĩ cho một người thân mắc bệnh nặng. Hai bác sĩ, An và Bình, hoạt động trong khu vực, và bạn so sánh tỷ lệ chữa khỏi của họ. Dữ liệu được trình bày như sau:
| Bác sĩ | Tổng ca | Chữa khỏi | Tỷ lệ (%) | Ca bệnh nặng | Chữa khỏi (nặng) | Tỷ lệ (nặng, %) | Ca bệnh nhẹ | Chữa khỏi (nhẹ) | Tỷ lệ (nhẹ, %) |
|---|---|---|---|---|---|---|---|---|---|
| An | 1000 | 900 | 90% | 100 | 50 | 50% | 900 | 850 | 94.4% |
| Bình | 1000 | 800 | 80% | 600 | 400 | 66.7% | 400 | 400 | 100% |
- Tổng thể: Bác sĩ An có tỷ lệ chữa khỏi cao hơn (90% so với 80% của Bình).
- Theo nhóm:
- Với ca bệnh nặng: Bình có tỷ lệ chữa khỏi cao hơn (66.7% so với 50% của An).
- Với ca bệnh nhẹ: Bình cũng vượt trội (100% so với 94.4% của An).
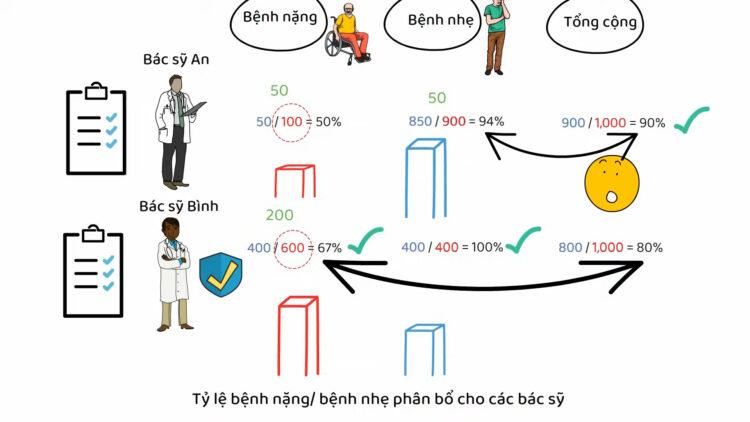
Tại sao lại có mâu thuẫn? Nghịch lý xuất hiện do tỷ trọng ca bệnh nặng khác nhau giữa hai bác sĩ: 60% ca của Bình là bệnh nặng (khó chữa hơn), trong khi chỉ 10% ca của An là bệnh nặng. Do đó, tỷ lệ tổng thể của Bình bị kéo xuống bởi số lượng lớn ca khó, trong khi An chủ yếu xử lý ca nhẹ, dễ đạt tỷ lệ cao hơn. Đây là một ví dụ điển hình của nghịch lý Simpson, như được phân tích trong Statistical Methods for Research Workers của Fisher (1925), nơi các biến điều chỉnh làm sai lệch kết luận tổng thể.
Ví dụ thực tế: Tuyển sinh tại UC Berkeley (1973)
Một trường hợp thực tế nổi tiếng của nghịch lý Simpson xảy ra trong dữ liệu tuyển sinh tại Đại học California, Berkeley năm 1973 (Bickel et al., 1975). Số liệu tổng thể cho thấy tỷ lệ chấp nhận sinh viên nam cao hơn nữ:
- Nam: 8.442 ứng viên, 44% được nhận.
- Nữ: 4.321 ứng viên, 35% được nhận.
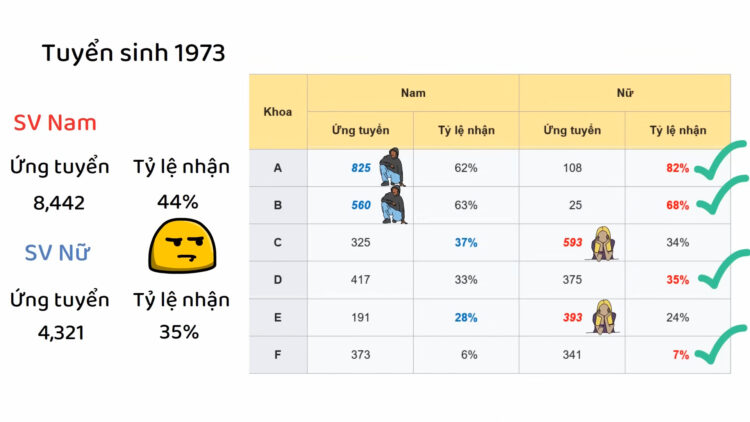
Điều này gợi ý sự phân biệt giới tính. Tuy nhiên, khi phân tích theo từng khoa, phần lớn các khoa (bao gồm các khoa lớn) có tỷ lệ chấp nhận nữ cao hơn hoặc tương đương nam. Lý do là nữ giới thường ứng tuyển vào các khoa cạnh tranh cao (như khoa C và E, với tỷ lệ nhận thấp), trong khi nam giới ưu tiên các khoa có tỷ lệ nhận cao hơn (như khoa A và B). Sự khác biệt trong phân bố lựa chọn khoa giữa hai giới đã tạo ra nghịch lý Simpson, làm sai lệch kết luận tổng thể.
Ví dụ bổ sung: Võ sĩ Cường và Dũng
Xét một kịch bản giả định về hai võ sĩ, Cường và Dũng, thi đấu trong hai năm (2018 và 2019):
| Võ sĩ | 2018 (Thắng/Đấu) | Tỷ lệ (2018) | 2019 (Thắng/Đấu) | Tỷ lệ (2019) | Tổng (Thắng/Đấu) | Tỷ lệ tổng |
|---|---|---|---|---|---|---|
| Cường | 20/20 | 100% | 50/52 | 96.2% | 70/72 | 97.2% |
| Dũng | 70/80 | 87.5% | 10/20 | 50% | 80/100 | 80% |
- Theo năm: Cường có tỷ lệ thắng cao hơn cả hai năm.
- Tổng thể: Dũng có số trận thắng cao hơn (80 so với 70).
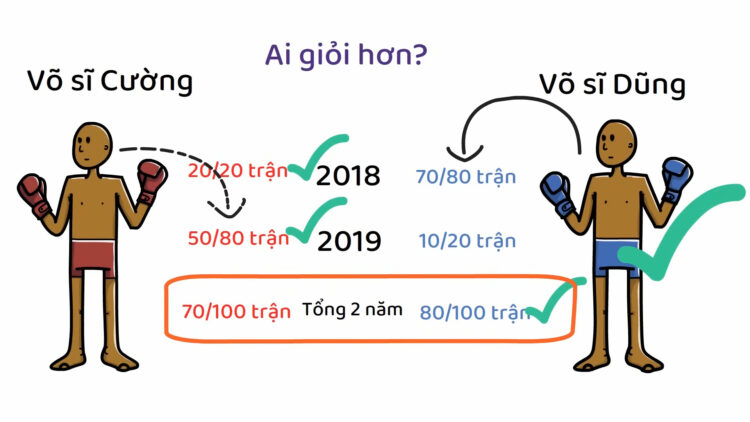
Mâu thuẫn này không phải là nghịch lý Simpson thực sự, vì các trận đấu trong hai năm có đặc điểm đồng đều (không có biến điều chỉnh như độ khó). Do đó, tỷ lệ tổng thể phản ánh chính xác hơn, và Dũng là võ sĩ vượt trội về số trận thắng. Ví dụ này nhấn mạnh tầm quan trọng của việc xác định xem biến điều chỉnh có ý nghĩa hay không, như được thảo luận trong Causality của Pearl (2009).
Ứng dụng và ý nghĩa liên ngành
Nghịch lý Simpson có tác động sâu rộng:
- Y học: Trong nghiên cứu y học, việc bỏ qua các biến điều chỉnh (như độ tuổi hoặc mức độ bệnh) có thể dẫn đến kết luận sai lầm về hiệu quả điều trị, như được minh họa trong các nghiên cứu của Altman (1991) về thống kê y khoa.
- Kinh tế học: Khi phân tích dữ liệu thị trường, các biến như thu nhập hoặc khu vực địa lý có thể làm sai lệch kết luận tổng thể về hành vi tiêu dùng.
- Phân tích dữ liệu: Các nhà khoa học dữ liệu cần cẩn trọng khi tổng hợp số liệu, sử dụng các kỹ thuật như phân tích phân tầng (stratification) để tránh nghịch lý Simpson.
- Chính sách công: Trong các vấn đề như phân bổ tài nguyên hoặc đánh giá chính sách, nghịch lý Simpson nhắc nhở rằng dữ liệu tổng thể có thể che giấu sự thật.
Kết luận
Nghịch lý Simpson là một lời cảnh báo mạnh mẽ về việc diễn giải dữ liệu một cách hời hợt. Cá nhân tôi từng bị cuốn hút bởi cách bài toán này lật ngược trực giác, như khi tôi so sánh hiệu quả công việc của hai đồng nghiệp mà không tính đến khối lượng công việc khác nhau của họ. Bài toán này dạy chúng ta rằng một con số tổng thể có thể đánh lừa nếu không xem xét các yếu tố ẩn. Bạn có từng gặp tình huống nào mà dữ liệu tổng thể dẫn bạn đến kết luận sai lầm? Hãy chia sẻ và thử áp dụng cách tiếp cận phân tích nhóm để khám phá sự thật. Để tìm hiểu thêm, tôi khuyên bạn đọc bài báo của Bickel et al. (1975) hoặc sách của Pearl về nhân quả.