

Tóm tắt các điểm chính
- Nemotron 3 là câu trả lời của NVIDIA cho những ràng buộc đang nổi lên của hệ thống multi-agent AI: chi phí inference tăng, coordination khó khăn, và context limit bị căng khi task chạy dài.
- Dòng model gồm 3 tier: Nano (30B param, 3B active), Super (~100B param, 10B active), và Ultra (~500B param, 50B active) — mỗi tier nhắm đến cân bằng khác nhau giữa reasoning depth, throughput, và efficiency.
- Kiến trúc hybrid latent mixture-of-experts (MoE) kết hợp với training 4-bit precision giúp giảm chi phí inference đáng kể trong khi duy trì accuracy.
- Nemotron 3 Nano hỗ trợ context window lên đến 1 triệu token và giảm tới 60% reasoning token so với Nemotron 2 — thay đổi game cho multi-agent workflow.
Nemotron 3 là gì?
Nemotron 3 là phản hồi của NVIDIA trước những ràng buộc đang nổi lên của hệ thống multi-agent AI. Khi các hệ thống AI chuyển sang multi-agent workflow, chi phí inference tăng lên, coordination trở nên khó khăn, và các task chạy dài làm căng giới hạn context.
Ý tưởng cốt lõi đằng sau Nemotron 3 là chuyên môn hóa (specialization). Một số agent cần nhẹ và nhanh, xử lý các task routine như routing hoặc summarization. Những agent khác chịu trách nhiệm phân tích sâu hơn hoặc long-horizon planning.
Bằng cách cung cấp nhiều model trong cùng một generation, Nemotron 3 hỗ trợ sự phân công lao động đó trong khi vẫn transparent và self-hostable.
Ba model trong dòng Nemotron 3
Nemotron 3 Nano
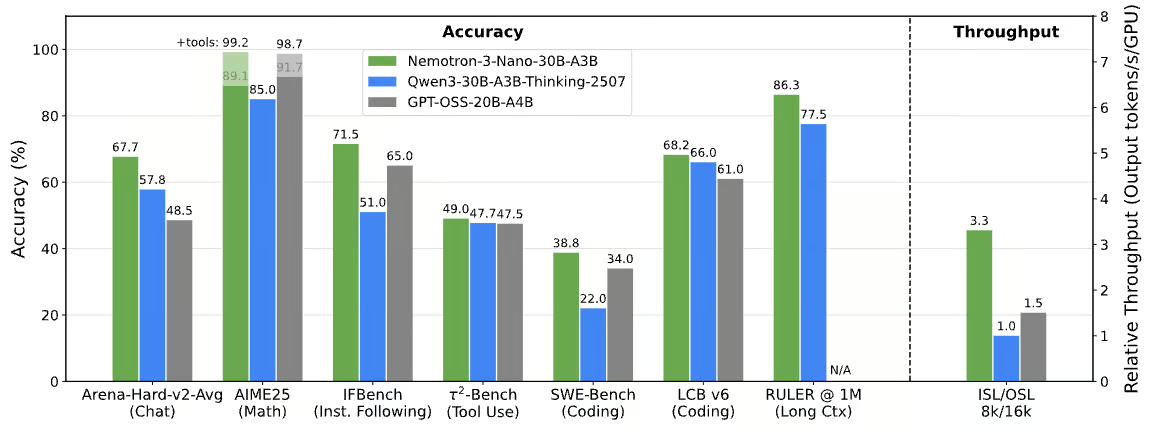
Nemotron 3 Nano là model tập trung vào efficiency nhất trong gia đình. Đây là model 30B-parameter kích hoạt tới 3B parameter mỗi token sử dụng kiến trúc hybrid mixture-of-experts.
Selective activation này cho phép Nano đạt throughput cao và chi phí inference thấp trong khi duy trì accuracy cạnh tranh cho kích thước của nó.
Use case phù hợp:
- Summarization
- Retrieval
- Classification
- General assistant workflow
Trong hệ thống multi-agent, Nano hoạt động tốt như high-volume worker xử lý các step thường xuyên hoặc intermediate mà không trở thành cost bottleneck.
Nemotron 3 Super
Nemotron 3 Super nhắm đến các scenario đòi hỏi reasoning mạnh hơn trong khi vẫn hoạt động dưới ràng buộc latency. Model có khoảng 100B parameter, với tới 10B active mỗi token, được optimize cho workload multi-agent có coordination.
Super nằm giữa Nano và Ultra — cung cấp năng lực reasoning cao hơn Nano mà không đòi hỏi compute đầy đủ của model lớn nhất. Đây là lựa chọn tốt cho agent cần combine nhiều input hoặc reason across step.
Nemotron 3 Ultra
Nemotron 3 Ultra là model năng lực cao nhất trong lineup. Với khoảng 500B parameter và tới 50B active mỗi token, nó đóng vai trò như high-end reasoning engine cho complex agentic workflow.
Ultra được thiết kế cho task liên quan đến:
- Deep analysis
- Long-horizon planning
- Strategic decision-making
Mặc dù có yêu cầu compute cao hơn, Ultra được thiết kế để hoạt động cùng với các model Nemotron nhỏ hơn — chỉ những task đòi hỏi nhất mới được route đến nó.
Điểm mới trong kiến trúc Nemotron 3
Thay vì dựa vào một breakthrough kiến trúc đơn lẻ, Nemotron 3 kết hợp nhiều lựa chọn thiết kế bổ trợ để làm cho hệ thống multi-agent lớn trở nên thực tế khi chạy.
Thiết kế Hybrid Latent Mixture-of-Experts
Cốt lõi của Nemotron 3 là kiến trúc hybrid latent mixture-of-experts (MoE). Thay vì kích hoạt tất cả parameter cho mọi token, model route mỗi token qua một subset nhỏ các expert network chuyên biệt.
Điều này giảm chi phí inference trong khi bảo toàn capacity của model lớn hơn nhiều. Trong hệ thống agent-based nơi nhiều agent có thể generate intermediate output đồng thời, selective activation giúp giữ yêu cầu compute ở mức quản lý được khi scale tăng.
Sử dụng 4-bit Precision trong Training
Nemotron 3 Super và Ultra được train sử dụng định dạng NVIDIA 4-bit NVFP4 precision trên kiến trúc Blackwell.
Training lower-precision giảm memory usage và tăng tốc training, cho phép làm việc với MoE model lớn hơn trên infrastructure hiện có. Quan trọng là điều này được thực hiện không có drop accuracy đáng kể so với định dạng higher-precision.
Context Window mở rộng cho Long Sequence
Nemotron 3 Nano hỗ trợ context window lên đến 1 triệu token. Điều này cho phép model retain thông tin trên toàn bộ long document, extended log, hoặc multi-step task history.
Với agent workflow như routing task giữa planning, retrieval, và execution agent — longer context giảm nhu cầu aggressive chunking hoặc external memory system.
Tính năng chính của Nemotron 3
Những quyết định kiến trúc này không trừu tượng — chúng hiện diện trực tiếp trong cách Nemotron 3 hoạt động trong hệ thống thực.
Giảm Reasoning Token Generation
NVIDIA báo cáo Nemotron 3 Nano generate ít hơn tới 60% reasoning token so với Nemotron 2 Nano.
Trong hệ thống multi-agent, nơi intermediate reasoning step có thể dominate tổng token usage, reduction này trực tiếp impact cost và scalability. Shorter reasoning trace giúp giữ inference hiệu quả mà không sacrifice task accuracy.
Throughput cao hơn cho Multi-step Workflow
Sự kết hợp của MoE routing và selective parameter activation cho phép Nemotron 3 duy trì high throughput khi workflow trở nên phức tạp hơn.
Điều này giúp dễ dàng support task chain dài hơn hoặc nhiều concurrent agent hơn mà không tăng latency tỷ lệ thuận.
Context Window 1M cho Long-horizon Reasoning
Với support lên đến 1 triệu token trong Nano, Nemotron 3 enable long-horizon reasoning trên extended input. Agent có thể reference earlier step hoặc large document mà không cần repeatedly summarizing hoặc reload state, improving consistency theo thời gian.
Nemotron 3 vs. Nemotron 2: Những cải tiến
So sánh với Nemotron 2 giúp validate liệu những design goal có translate thành measurable improvement hay không.
| Khía cạnh | Nemotron 2 | Nemotron 3 |
|---|---|---|
| MoE Routing | Cơ bản | Refined, hiệu quả hơn |
| Token Throughput | Baseline | Lên đến 4× cao hơn (Nano) |
| Reasoning Token | Baseline | Giảm tới 60% |
| Context Length | Giới hạn | Lên đến 1M token |
| Phạm vi | Chủ yếu model release | Stack hoàn chỉnh cho agent development |
Một khác biệt quan trọng khác là phạm vi. Nemotron 3 mở rộng beyond model alone, đi kèm với:
- Reinforcement learning dataset
- Agent safety data
- Open tooling như NeMo Gym và NeMo RL
Nemotron 2 tập trung chủ yếu vào model release, trong khi Nemotron 3 được định vị như stack hoàn chỉnh hơn cho agent development.
Nemotron 3 vs. Đối thủ cạnh tranh
NVIDIA không positioning Nemotron 3 như drop-in replacement cho frontier proprietary model. Thay vào đó, nó nhắm đến challenge khác: làm cho hệ thống AI agent-based efficient, predictable, và scalable trong real deployment.
So với các large open model khác, Nemotron 3 ít nhấn mạnh việc maximize single-model benchmark score và tập trung nhiều hơn vào system-level concern như throughput, reasoning-token efficiency, long context handling, và coordination across agent.
Bảng so sánh tổng quan
| Dimension | Nemotron 3 | Mistral Large 3 | DeepSeek-Class Models | Frontier Proprietary |
|---|---|---|---|---|
| Primary Design Goal | Multi-agent efficiency at scale | Single-model capability | Reasoning depth per prompt | Frontier reasoning & agents |
| Architecture Focus | Hybrid latent MoE | Sparse MoE | Dense / MoE | Dense, proprietary |
| Throughput | Rất cao (Nano dẫn đầu peers) | Cao nhưng compute-heavy | Moderate | Moderate to high |
| Reasoning Token Usage | Giảm (tới ~60% ít hơn ở Nano) | Moderate | Higher | Higher |
| Context Window | Lên đến 1M token (Nano) | Lên đến ~256K | Long, nhưng nhỏ hơn | Long (varies) |
| Multi-Agent Suitability | Xuất sắc | Moderate | Moderate | Strong nhưng đắt |
| Self-Hosting & Control | Full (open weights) | Full (open weights) | Full (open weights) | Limited / none |
| Best Use Case | Agent coordination, routing, summarization | Deep reasoning, coding | Math & reasoning tasks | Complex planning, SWE |
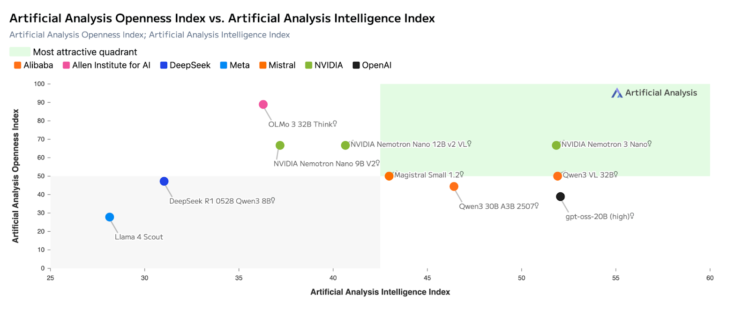
Nemotron 3 vs. Mistral Large 3
Mistral Large 3 và Nemotron 3 đều dựa vào kiến trúc mixture-of-experts, nhưng chúng optimize cho outcome khác nhau.
Mistral Large 3 được thiết kế để maximize single-model capability, perform strongly trên reasoning, coding, và general-purpose benchmark như LMArena và SWE-style evaluation. Đây thường là lựa chọn tốt hơn khi một model được kỳ vọng handle toàn bộ task end-to-end.
Nemotron 3, ngược lại, được optimize cho system-level efficiency. Hybrid latent MoE design kích hoạt ít parameter hơn mỗi token và ưu tiên throughput over peak reasoning depth. Điều này làm nó phù hợp hơn cho coordination-heavy role — routing, summarization, và intermediate reasoning nơi nhiều agent operate đồng thời.
Cách truy cập Nemotron 3
NVIDIA cung cấp nhiều path truy cập, từ fully hosted API đến self-managed deployment.
API Access qua Hosted Inference Provider
Cách nhanh nhất để bắt đầu là thông qua hosted inference provider. Nemotron 3 Nano hiện có sẵn trên các platform:
- Baseten
- DeepInfra
- Fireworks
- FriendliAI
- OpenRouter
- Together AI
Các service này expose standard API interface, cho phép test behavior, throughput, và long-context handling của model mà không cần provision hardware.
Open Weights và Self-hosting
Các model Nemotron 3 cũng được release với open weights trên Hugging Face, cho phép kiểm soát đầy đủ deployment.
Với open weights, bạn có thể:
- Chạy model trên infrastructure của mình
- Modify hoặc fine-tune theo nhu cầu
- Quản lý latency, privacy, và cost end-to-end
NVIDIA NIM và Deployment Framework
Cho team muốn trải nghiệm self-hosting được quản lý hơn, Nemotron 3 Nano cũng có sẵn như NVIDIA NIM microservice. NIM package model cho secure, scalable deployment trên NVIDIA-accelerated infrastructure — on-premises hoặc cloud.
Timeline khả dụng
| Model | Trạng thái |
|---|---|
| Nemotron 3 Nano | Có sẵn ngay (hosted API, open weights, NIM) |
| Nemotron 3 Super | Dự kiến H1/2026 |
| Nemotron 3 Ultra | Dự kiến H1/2026 |
Nemotron 3 tốt đến mức nào?
Nemotron 3 mạnh trong phạm vi intended của nó. Đóng góp chính không phải là đẩy giới hạn của single-model reasoning, mà là làm cho hệ thống agent-based thực tế hơn để deploy và scale.
Các lựa chọn kiến trúc translate thành lợi ích operational thực, đặc biệt cho workflow dựa vào nhiều cooperating agent.
Tuy nhiên, nếu yêu cầu chính là deep, single-model reasoning hoặc complex tool-driven planning, frontier proprietary model vẫn có xu hướng consistent hơn.
Nhìn qua lens đúng, Nemotron 3 bổ trợ những model đó hơn là thay thế chúng.
Use Case của Nemotron 3
Nemotron 3 phù hợp nhất trong scenario nơi efficiency, transparency, và scalability quan trọng:
| Use Case | Mô tả |
|---|---|
| Multi-agent Systems | Routing, coordination, và intermediate reasoning |
| Long-document Processing | Summarization, extraction, và analysis trên large input |
| Enterprise Assistants | Internal tool đòi hỏi predictable performance và self-hosting |
| Workflow Automation | Classification, retrieval, và decision support at scale |
| Privacy-sensitive Deployments | On-premises hoặc sovereign AI environment |
Vì các model là open và được thiết kế để work together, team có thể assign role khác nhau cho model size khác nhau thay vì dựa vào một hệ thống monolithic đơn lẻ.
Tổng kết
Focus của NVIDIA vào efficiency, openness, và system-level design phản ánh cách nhiều ứng dụng AI real-world đang được build hiện nay.
Điều thú vị về Nemotron 3 là góc nhìn của nó. Thay vì chạy đua benchmark với câu hỏi “model nào đạt điểm cao nhất?”, NVIDIA đặt câu hỏi khác: “Làm sao để nhiều model làm việc cùng nhau một cách hiệu quả?”
Đây là sự thừa nhận rằng tương lai của AI không phải là một super-model làm mọi thứ, mà là orchestra của nhiều model chuyên biệt — mỗi model làm tốt nhất việc của mình.
Nhìn như một phần của hệ thống lớn hơn, Nemotron 3 cảm giác ít giống một model release và nhiều hơn như nền tảng cho cách AI agent-based đang được deploy ngày nay.
Câu hỏi thường gặp (FAQ)
Nemotron 3 là gì?
Nemotron 3 là dòng model AI của NVIDIA được thiết kế cho hệ thống multi-agent, gồm 3 tier (Nano, Super, Ultra) với kiến trúc hybrid latent mixture-of-experts giúp cân bằng giữa reasoning depth, throughput, và efficiency.
Sự khác biệt giữa Nano, Super, và Ultra?
Nano (30B param, 3B active) cho high-volume task nhanh; Super (~100B param, 10B active) cho reasoning mạnh hơn với latency constraint; Ultra (~500B param, 50B active) cho complex agentic workflow đòi hỏi deep analysis.
Nemotron 3 có gì mới so với Nemotron 2?
Throughput cao hơn tới 4×, giảm 60% reasoning token, context window lên 1M token, và đi kèm stack hoàn chỉnh gồm RL dataset, agent safety data, và tooling như NeMo Gym.
Làm sao để truy cập Nemotron 3?
Nemotron 3 Nano có sẵn qua hosted API (Baseten, DeepInfra, Together AI…), open weights trên Hugging Face, và NVIDIA NIM. Super và Ultra dự kiến H1/2026.
Nemotron 3 phù hợp với use case nào?
Multi-agent coordination, long-document processing, enterprise assistant, workflow automation, và privacy-sensitive deployment đòi hỏi self-hosting.
Nemotron 3 có thay thế được frontier model như GPT-4 hay Claude không?
Không hoàn toàn. Nemotron 3 complement thay vì replace — nó excel ở system-level efficiency và multi-agent coordination, trong khi frontier proprietary model vẫn mạnh hơn ở deep single-model reasoning.
Câu hỏi thường gặp
Nemotron 3 là gì?
Nemotron 3 là dòng model AI của NVIDIA được thiết kế cho hệ thống multi-agent, gồm 3 tier (Nano, Super, Ultra) với kiến trúc hybrid latent mixture-of-experts giúp cân bằng giữa reasoning depth, throughput, và efficiency.
Sự khác biệt giữa Nano, Super, và Ultra?
Nano (30B param, 3B active) cho high-volume task nhanh; Super (~100B param, 10B active) cho reasoning mạnh hơn với latency constraint; Ultra (~500B param, 50B active) cho complex agentic workflow đòi hỏi deep analysis.
Nemotron 3 có gì mới so với Nemotron 2?
Throughput cao hơn tới 4×, giảm 60% reasoning token, context window lên 1M token, và đi kèm stack hoàn chỉnh gồm RL dataset, agent safety data, và tooling như NeMo Gym.
Làm sao để truy cập Nemotron 3?
Nemotron 3 Nano có sẵn qua hosted API (Baseten, DeepInfra, Together AI…), open weights trên Hugging Face, và NVIDIA NIM. Super và Ultra dự kiến H1/2026.
Nemotron 3 phù hợp với use case nào?
Multi-agent coordination, long-document processing, enterprise assistant, workflow automation, và privacy-sensitive deployment đòi hỏi self-hosting.
Nemotron 3 có thay thế được frontier model như GPT-4 hay Claude không?
Không hoàn toàn. Nemotron 3 complement thay vì replace — nó excel ở system-level efficiency và multi-agent coordination, trong khi frontier proprietary model vẫn mạnh hơn ở deep single-model reasoning.